
乱码是什么原因导致的,有哪些有效解法?
- 内容介绍
- 文章标签
- 相关推荐
不过,
加入监控告警,当连续出现超过 N 条含有非标准 Unicode 的日志时发送报警给运维团队。
对 AI 接口响应做双向校验。并将返回内容以 Base64 存储,以避免因网络波动导致直接字节流破损。<小尺寸>
对外提供 “文本修复 API”。允许前端提交疑似乱码字符串,由后台自动识别并返回最佳解码结果。按理说,<小尺寸>
在 UI 上加入 “支持多语言选择”。让使用者自行切换页面语言,同时自动调整内嵌字体与 CSS 的 `` 设置,以兼容不同地区使用者需求。<小尺寸>
>

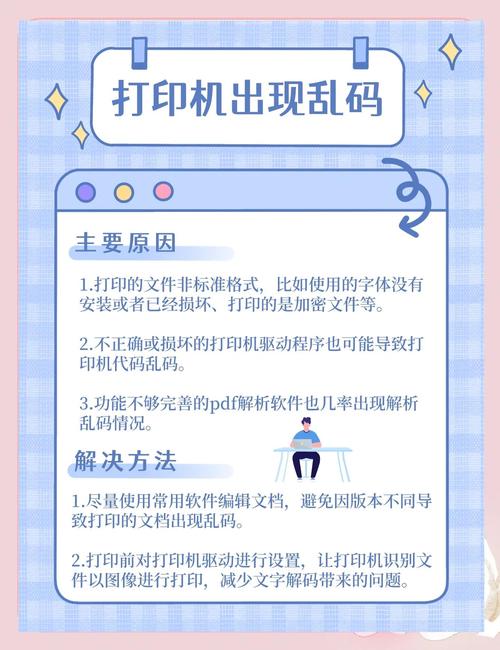
在日常工作中。浏览网页、打开文档、查看邮件或使用各种软件时常常会遇到“乱码”——字符无法正确显示,看起来像一串无意义的符号。老实说,这个问题不仅让人头疼,也会影响工作效率和信息沟通。
1️⃣ 为什么会出现乱码?
乱码产生的根本原因是字符编码不一致。计算机内部使用二进制表示字符,而不同语言或程序采用不同的编码规则。出现看似随机的字母、符号甚至“�”等奇怪字符。
说到使用者痛点。无法识别文本内容,导致误解或信息丢失。
2️⃣ 常见的乱码原因
- 文件本身编码与阅读器设置不匹配:比如用 UTF‑8 编码保存的文件,却在只支持 GBK 的编辑器里打开。
- 浏览器/邮件客户端默认编码错误:服务器返回的数据未声明 charset 或声明错误,导致浏览器按默认值解析。
- 数据库字符集配置不当:存储时使用了 latin1。但读取时用 utf8mb4,导致中文字段变成乱码。
- SFTP/FTP 文件传输过程中的转码错误:
- A/B 程序间通信缺少统一标准:
至于使用者痛点,"为什么我看到的是一堆莫名其妙的符号?"
3️⃣ 如何快速定位并恢复乱码?
步骤一:确认原始编码
原始编码 = "GBK" // 或者 "ISO‑8859‑1"
目标编码 = "UTF‑8"
已知源文件 = bytes_data
// 在 Java 中示例:
String fixed = new String;String utf8Str = new String,targetEncoding);
步骤二:尝试常见编码组合自动检测
String encodings = {"UTF-8"。"GBK","GB2312","ISO-8859-1"};for {
for {
try{
String res = new String.getBytes;// 若显示正常,即为正确组合
}catch{}
}
}
步骤三:若无原始编码信息。可通过在线工具或专业软件手动切换尝试。
从使用者痛点来看,"没有经验,不知道从哪开始排查。浪费大量时间"
4️⃣ AI 与大模型生成内容中的乱码问题
A.I. 程序在生成文本时一样可能因为以下因素导致乱码:
- 模型训练数据不足或质量低下:- 对罕见字符预测失败。 说起来,
- 输入输出接口未统一使用 UTF‑8:- 网络传输层转换错误。
- 硬件/网络波动导致字节丢失:- TCP 包乱序或丢包。
- 多语言混合输入引发冲突:- 同一段话中出现中文、俄文、特殊符号等交叉。
从使用者痛点来看,"AI 输出结果全是乱七八糟。让人怀疑程序可信度"
5️⃣ 预防与方法汇总
⚙️ 确保统一使用 UTF‑8 编码
🛠️ 开发者侧技术细节
对所有外部 API 调用做双向校验;若返回 `content-type` 缺失,则手动指定为 UTF‑8。
在日志程序中记录每条消息的实际字节长度和标记,以便后期追踪异常。不过,
对模型输出进行正则校验;话说回来,若检测到非 ASCII 且长度不符合预期。则触发回退策略,如重新调用模型或提示使用者重试。
定期更新训练语料。
特别是多语言、多数据集,提高模型对罕见字符的预测准确率。
其实,
为前端提供 “自动纠正” 按钮。一键把当前页面切换到 “Auto-detect Encoding”,自动尝试常见组合。
不过,
加入监控告警,当连续出现超过 N 条含有非标准 Unicode 的日志时发送报警给运维团队。
对 AI 接口响应做双向校验。并将返回内容以 Base64 存储,以避免因网络波动导致直接字节流破损。<小尺寸>
对外提供 “文本修复 API”。允许前端提交疑似乱码字符串,由后台自动识别并返回最佳解码结果。按理说,<小尺寸>
在 UI 上加入 “支持多语言选择”。让使用者自行切换页面语言,同时自动调整内嵌字体与 CSS 的 `` 设置,以兼容不同地区使用者需求。<小尺寸>
>
在日常工作中。浏览网页、打开文档、查看邮件或使用各种软件时常常会遇到“乱码”——字符无法正确显示,看起来像一串无意义的符号。老实说,这个问题不仅让人头疼,也会影响工作效率和信息沟通。
1️⃣ 为什么会出现乱码?
乱码产生的根本原因是字符编码不一致。计算机内部使用二进制表示字符,而不同语言或程序采用不同的编码规则。出现看似随机的字母、符号甚至“�”等奇怪字符。
说到使用者痛点。无法识别文本内容,导致误解或信息丢失。
2️⃣ 常见的乱码原因
- 文件本身编码与阅读器设置不匹配:比如用 UTF‑8 编码保存的文件,却在只支持 GBK 的编辑器里打开。
- 浏览器/邮件客户端默认编码错误:服务器返回的数据未声明 charset 或声明错误,导致浏览器按默认值解析。
- 数据库字符集配置不当:存储时使用了 latin1。但读取时用 utf8mb4,导致中文字段变成乱码。
- SFTP/FTP 文件传输过程中的转码错误:
- A/B 程序间通信缺少统一标准:
至于使用者痛点,"为什么我看到的是一堆莫名其妙的符号?"
3️⃣ 如何快速定位并恢复乱码?
步骤一:确认原始编码
原始编码 = "GBK" // 或者 "ISO‑8859‑1"
目标编码 = "UTF‑8"
已知源文件 = bytes_data
// 在 Java 中示例:
String fixed = new String;String utf8Str = new String,targetEncoding);
步骤二:尝试常见编码组合自动检测
String encodings = {"UTF-8"。"GBK","GB2312","ISO-8859-1"};for {
for {
try{
String res = new String.getBytes;// 若显示正常,即为正确组合
}catch{}
}
}
步骤三:若无原始编码信息。可通过在线工具或专业软件手动切换尝试。
从使用者痛点来看,"没有经验,不知道从哪开始排查。浪费大量时间"
4️⃣ AI 与大模型生成内容中的乱码问题
A.I. 程序在生成文本时一样可能因为以下因素导致乱码:
- 模型训练数据不足或质量低下:- 对罕见字符预测失败。 说起来,
- 输入输出接口未统一使用 UTF‑8:- 网络传输层转换错误。
- 硬件/网络波动导致字节丢失:- TCP 包乱序或丢包。
- 多语言混合输入引发冲突:- 同一段话中出现中文、俄文、特殊符号等交叉。
从使用者痛点来看,"AI 输出结果全是乱七八糟。让人怀疑程序可信度"
5️⃣ 预防与方法汇总
⚙️ 确保统一使用 UTF‑8 编码
🛠️ 开发者侧技术细节
对所有外部 API 调用做双向校验;若返回 `content-type` 缺失,则手动指定为 UTF‑8。
在日志程序中记录每条消息的实际字节长度和标记,以便后期追踪异常。不过,
对模型输出进行正则校验;话说回来,若检测到非 ASCII 且长度不符合预期。则触发回退策略,如重新调用模型或提示使用者重试。
定期更新训练语料。
特别是多语言、多数据集,提高模型对罕见字符的预测准确率。
其实,
为前端提供 “自动纠正” 按钮。一键把当前页面切换到 “Auto-detect Encoding”,自动尝试常见组合。