
乱码是什么原因导致的,有哪些有效解法?
- 内容介绍
- 文章标签
- 相关推荐
不过,
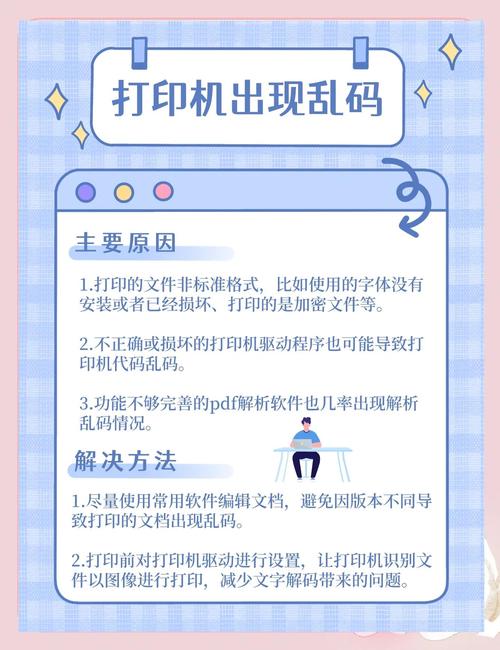
在日常工作中。浏览网页、打开文档、查看邮件或使用各种软件时常常会遇到“乱码”——字符无法正确显示,看起来像一串无意义的符号。老实说,这个问题不仅让人头疼,也会影响工作效率和信息沟通。
1️⃣ 为什么会出现乱码?
乱码产生的根本原因是字符编码不一致。计算机内部使用二进制表示字符,而不同语言或程序采用不同的编码规则。出现看似随机的字母、符号甚至“�”等奇怪字符。
说到使用者痛点。无法识别文本内容,导致误解或信息丢失。
2️⃣ 常见的乱码原因
- 文件本身编码与阅读器设置不匹配:比如用 UTF‑8 编码保存的文件,却在只支持 GBK 的编辑器里打开。
- 浏览器/邮件客户端默认编码错误:服务器返回的数据未声明 charset 或声明错误,导致浏览器按默认值解析。
- 数据库字符集配置不当:存储时使用了 latin1。但读取时用 utf8mb4,导致中文字段变成乱码。
不过,
在日常工作中。浏览网页、打开文档、查看邮件或使用各种软件时常常会遇到“乱码”——字符无法正确显示,看起来像一串无意义的符号。老实说,这个问题不仅让人头疼,也会影响工作效率和信息沟通。
1️⃣ 为什么会出现乱码?
乱码产生的根本原因是字符编码不一致。计算机内部使用二进制表示字符,而不同语言或程序采用不同的编码规则。出现看似随机的字母、符号甚至“�”等奇怪字符。
说到使用者痛点。无法识别文本内容,导致误解或信息丢失。
2️⃣ 常见的乱码原因
- 文件本身编码与阅读器设置不匹配:比如用 UTF‑8 编码保存的文件,却在只支持 GBK 的编辑器里打开。
- 浏览器/邮件客户端默认编码错误:服务器返回的数据未声明 charset 或声明错误,导致浏览器按默认值解析。
- 数据库字符集配置不当:存储时使用了 latin1。但读取时用 utf8mb4,导致中文字段变成乱码。